EXPERIMENT 03 / 文字と画像
OCRの信頼度89を、正答率89%と読んでよい?原稿と照合する
OCR画面の信頼度は、原稿と照合して計算した正答率ではありません。架空の会議案内を使った実際の認識結果から、どこまで読み取れていて、何を人が確認する必要があるかを調べました。
検証条件
PDFざんまいで2026年11月16日に記録された英語OCRサンプルと出力を再点検。Tesseract系エンジンが返した信頼度89と、原稿の表示を別々に確認しました。
原稿と、実際に出た文章
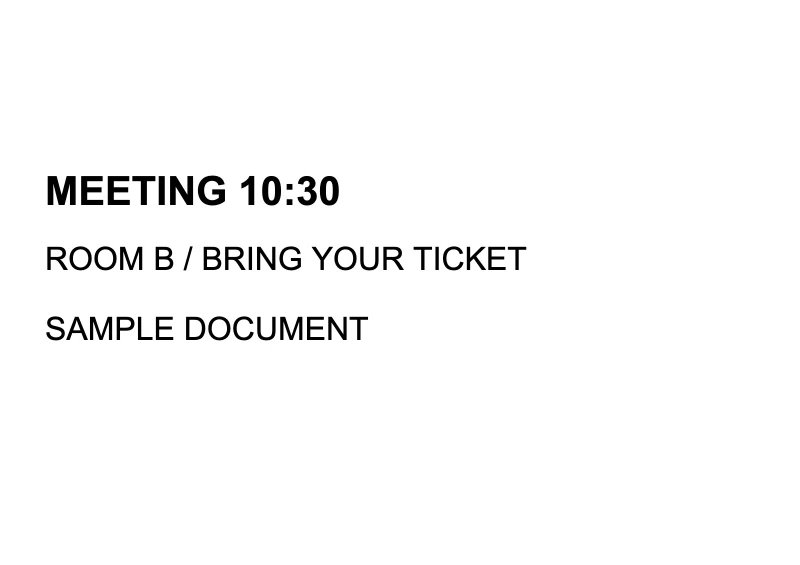
| 原稿の行 | 出力の行 | 確認した点 |
|---|---|---|
| MEETING 10:30 | MEETING 10:30 | 時刻とコロンは一致 |
| ROOM B / BRING YOUR TICKET | ROOM B/ BRING YOUR TICKET | Bとスラッシュの間の空白が変化 |
| SAMPLE DOCUMENT | SAMPLE DOCUMENT | 文字列は一致 |
出力では行間に空行も入りました。文章の大意が読めることと、原稿のレイアウトや空白をそのまま再現することは違います。コピーして別の資料に貼るときは、この差が残ります。
信頼度からは分からないこと
信頼度は、認識エンジンが自分の候補をどれくらい確からしいと判断したかを表す値です。ここでは文字ごとの正解ラベルを用意して集計していないため、文字正答率や単語正答率を算出していません。「89文字中何文字が正しかった」という意味でもありません。
今回の原稿は短い英語の印刷文字で、手書き・日本語・縦書き・低解像度の写真は比較対象に含めていません。この一例から「OCRは常に高精度」と一般化することはできません。
先に確認する場所を決める
- OCR後の文章を原稿の横に並べ、行単位で照合します。見出しだけで判断しません。
- 時刻、日付、数量、単位、記号を先に確認します。「10:30」が「10:80」になれば、意味が変わります。
- 空白や改行を整えた後、原稿の行を読み飛ばしていないか、重複していないかを再確認します。
認識しにくい場合は、原稿の傾き、暗さ、ピント、文字の大きさを見直します。補正で改善する可能性はありますが、この検証では撮影条件を変えた比較までは行っていません。
保存前の使い分け
目で読むための案内文なら空白の調整で済むこともありますが、表への転記や番号の照合では一文字の違いが問題になります。OCRを下書きとして使い、必要な正確さに合わせて確認範囲を決めると作業を組み立てやすくなります。
今回の入力PDFと生の認識テキストを下に置きました。まず出力を編集せずに見比べ、その後にコピー用の文章を整えると、どの差を人が修正したか追跡できます。
サンプルと確認資料
資料は検証用のサンプルや計算記録です。入力条件と結果を見比べて確認できます。掲載の結果は各記事に記した条件での観察・計算です。
- OCRに使った画像PDF PDF / 50.5 KB
- 編集前のOCR出力テキスト テキスト / 0.1 KB
参考資料と、数値の記録
数値と比較結果のJSONも公開しています。公開日と元の操作記録日が異なる場合は、検証条件に区別して記載しています。